Réidentification : le problème n’est pas l’identité, c’est l’histoire
Peut-on vraiment anonymiser les écrits du secteur pour les exploiter avec une IA ? Nos travaux mesurent le risque de réidentification : un récit marquant pèse plus que l’identité.
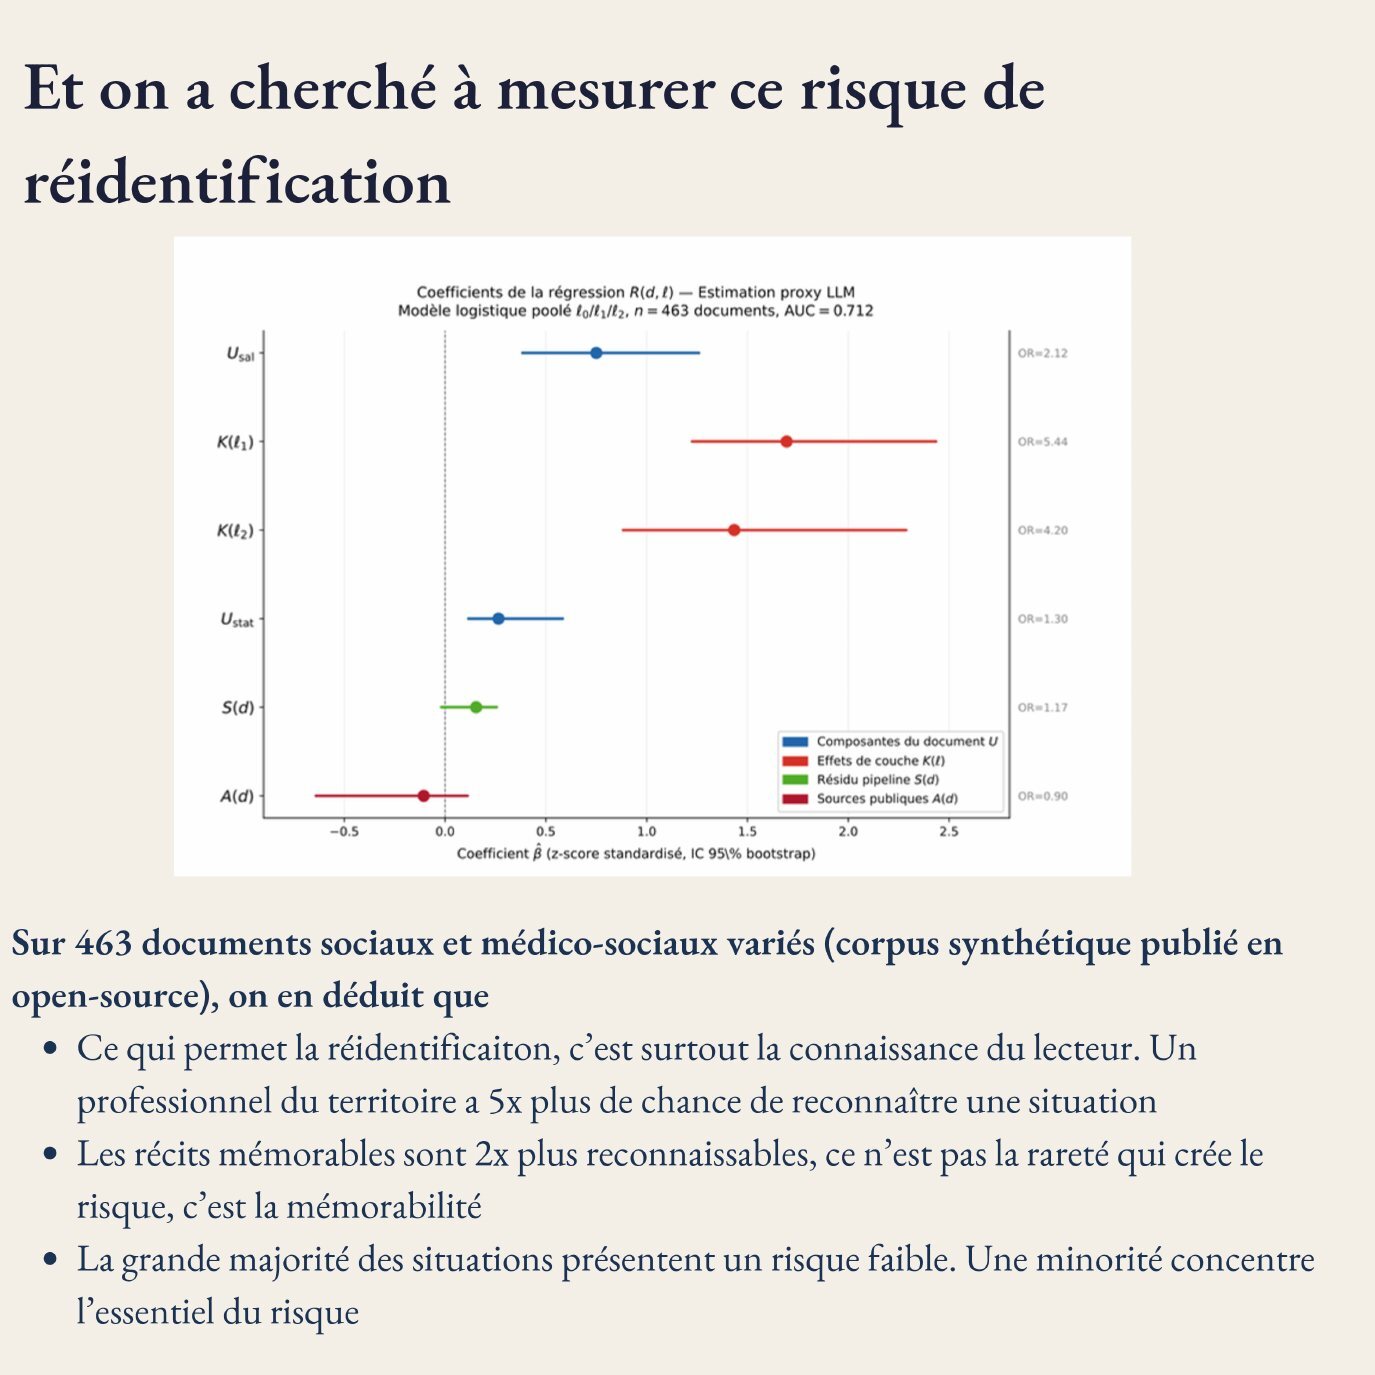
Une formule de probabilité et un graphique d’odds ratios : ce n’est pas ce qu’on attend en ouvrant une page sur l’IA. Pourtant, derrière ces graphiques se cache une question très concrète : peut-on réellement anonymiser les documents qu’on souhaite exploiter avec une IA ?
Un exemple
Imaginez un rapport social décrivant un usager de CHRS ayant parcouru 800 kilomètres à pied pour retrouver son chien. Vous pouvez supprimer son nom, son prénom, sa date de naissance et son adresse : vous pourrez quand même retrouver la situation (et le chien, espérons-le).
Le problème n’est pas l’identité. Le problème, c’est l’histoire.
Ce que dit le droit
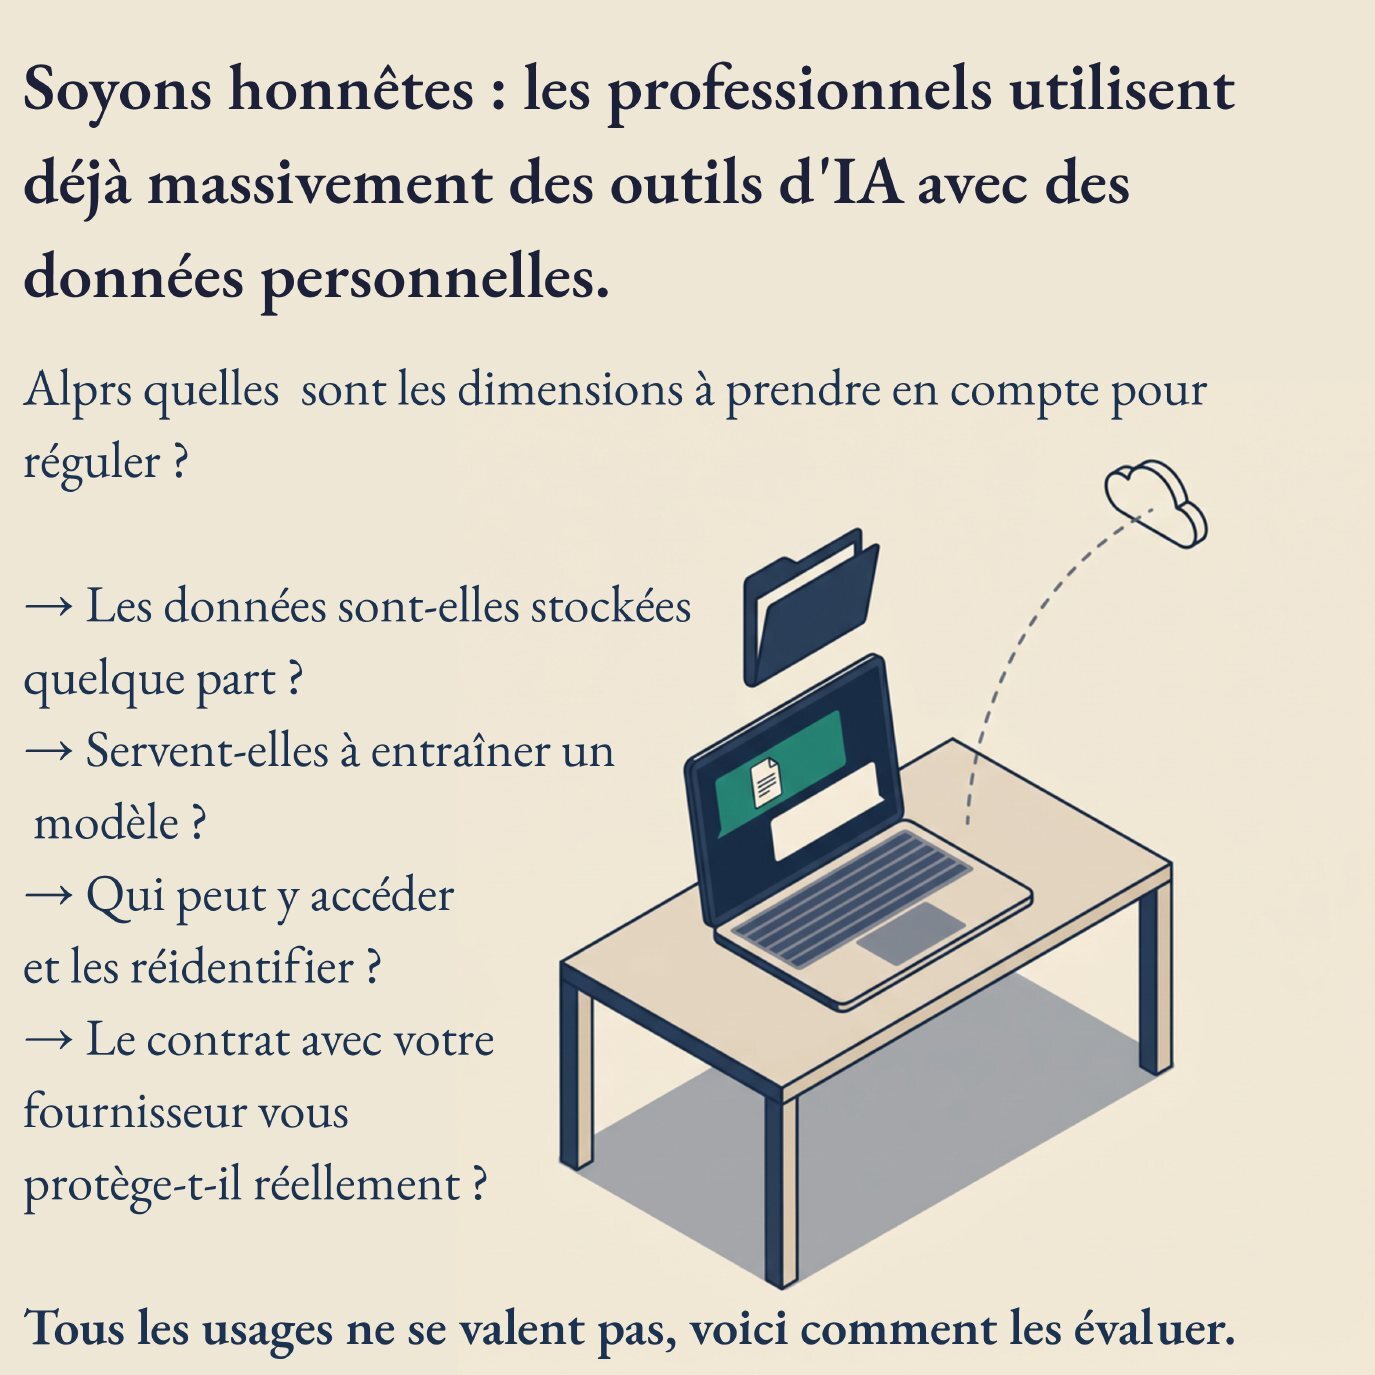
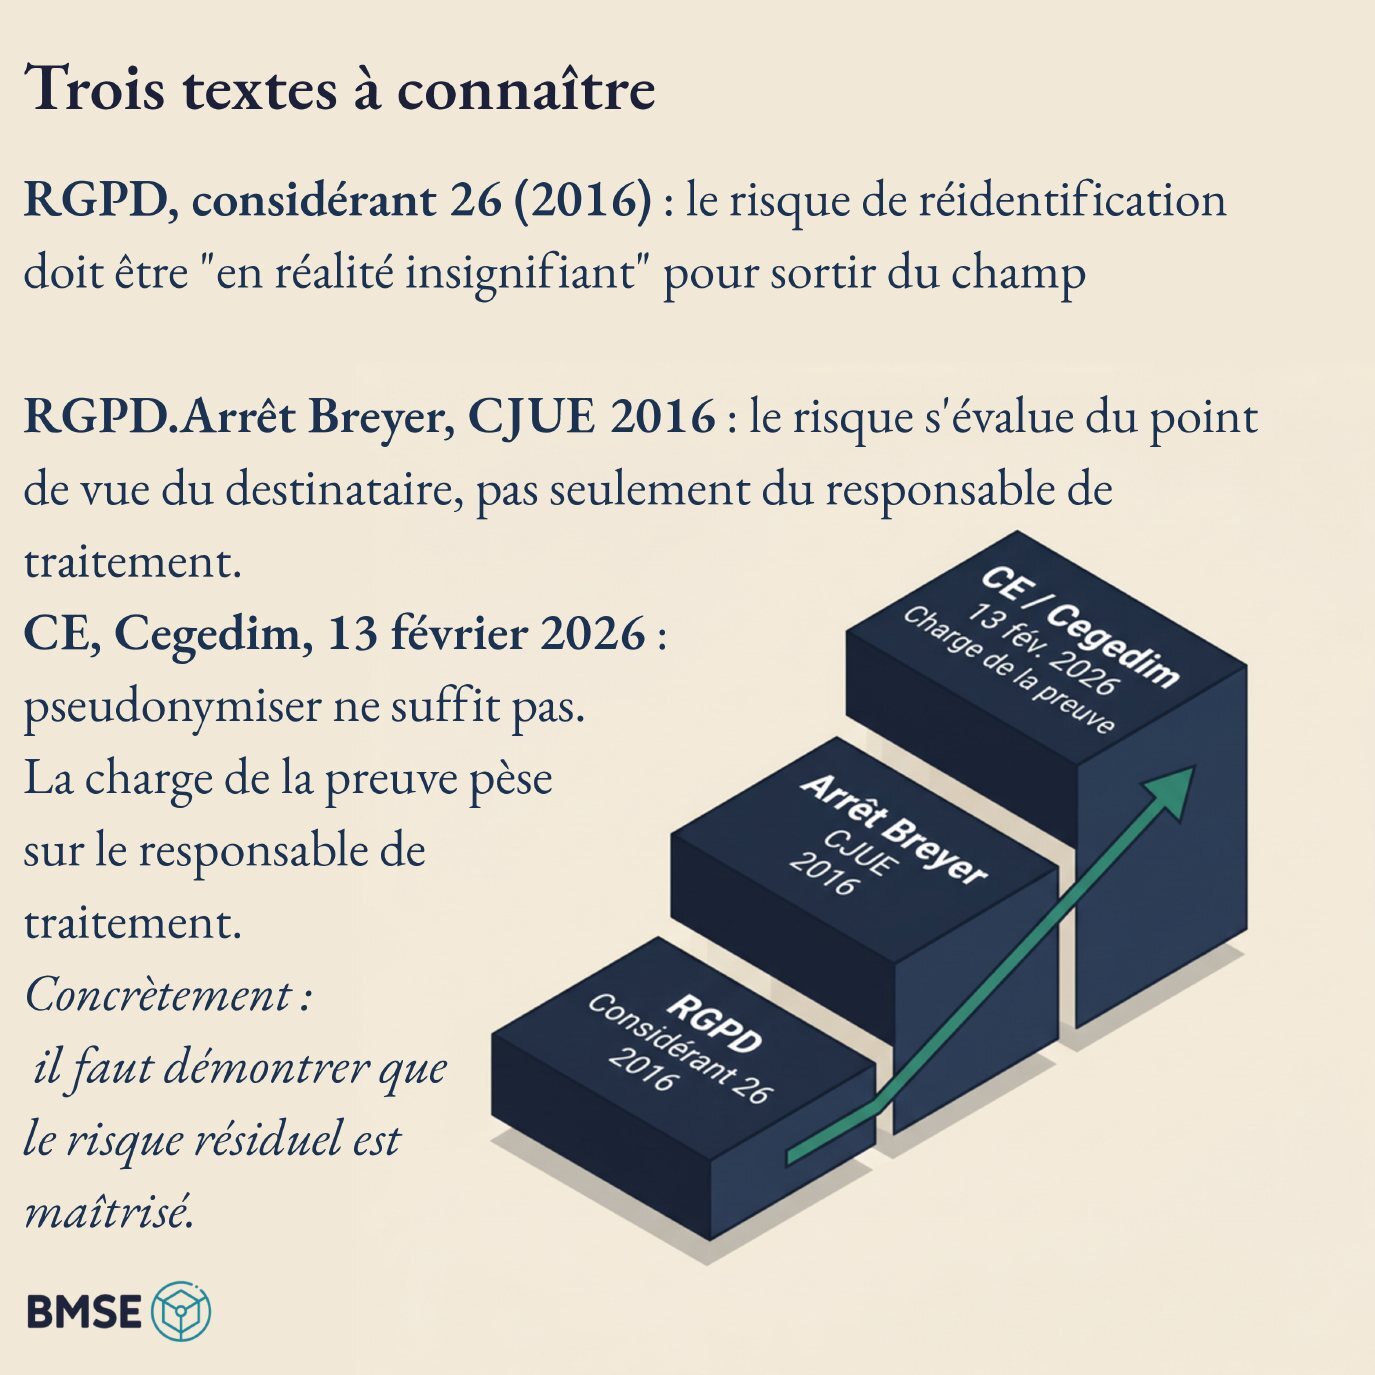
Les professionnels utilisent déjà massivement des outils d’IA avec des données personnelles. Trois textes permettent de comprendre ce qui est exigé :
- le RGPD, considérant 26 (2016) : le risque de réidentification doit être « en réalité insignifiant » pour sortir du champ du règlement ;
- l’arrêt Breyer de la CJUE (2016) : le risque s’évalue du point de vue du destinataire, pas seulement de celui du responsable de traitement ;
- la décision du Conseil d’État du 13 février 2026 (Cegedim) : pseudonymiser ne suffit pas, et la charge de la preuve pèse sur le responsable de traitement. Le Conseil d’État a confirmé une amende de 800 000 € contre une société qui pensait ses données de santé protégées par pseudonymisation : le juge a constaté qu’on pouvait reconstituer des parcours de soins avec un simple tableur.
Concrètement, il faut démontrer que le risque résiduel est maîtrisé.
Tous les usages ne se valent pas
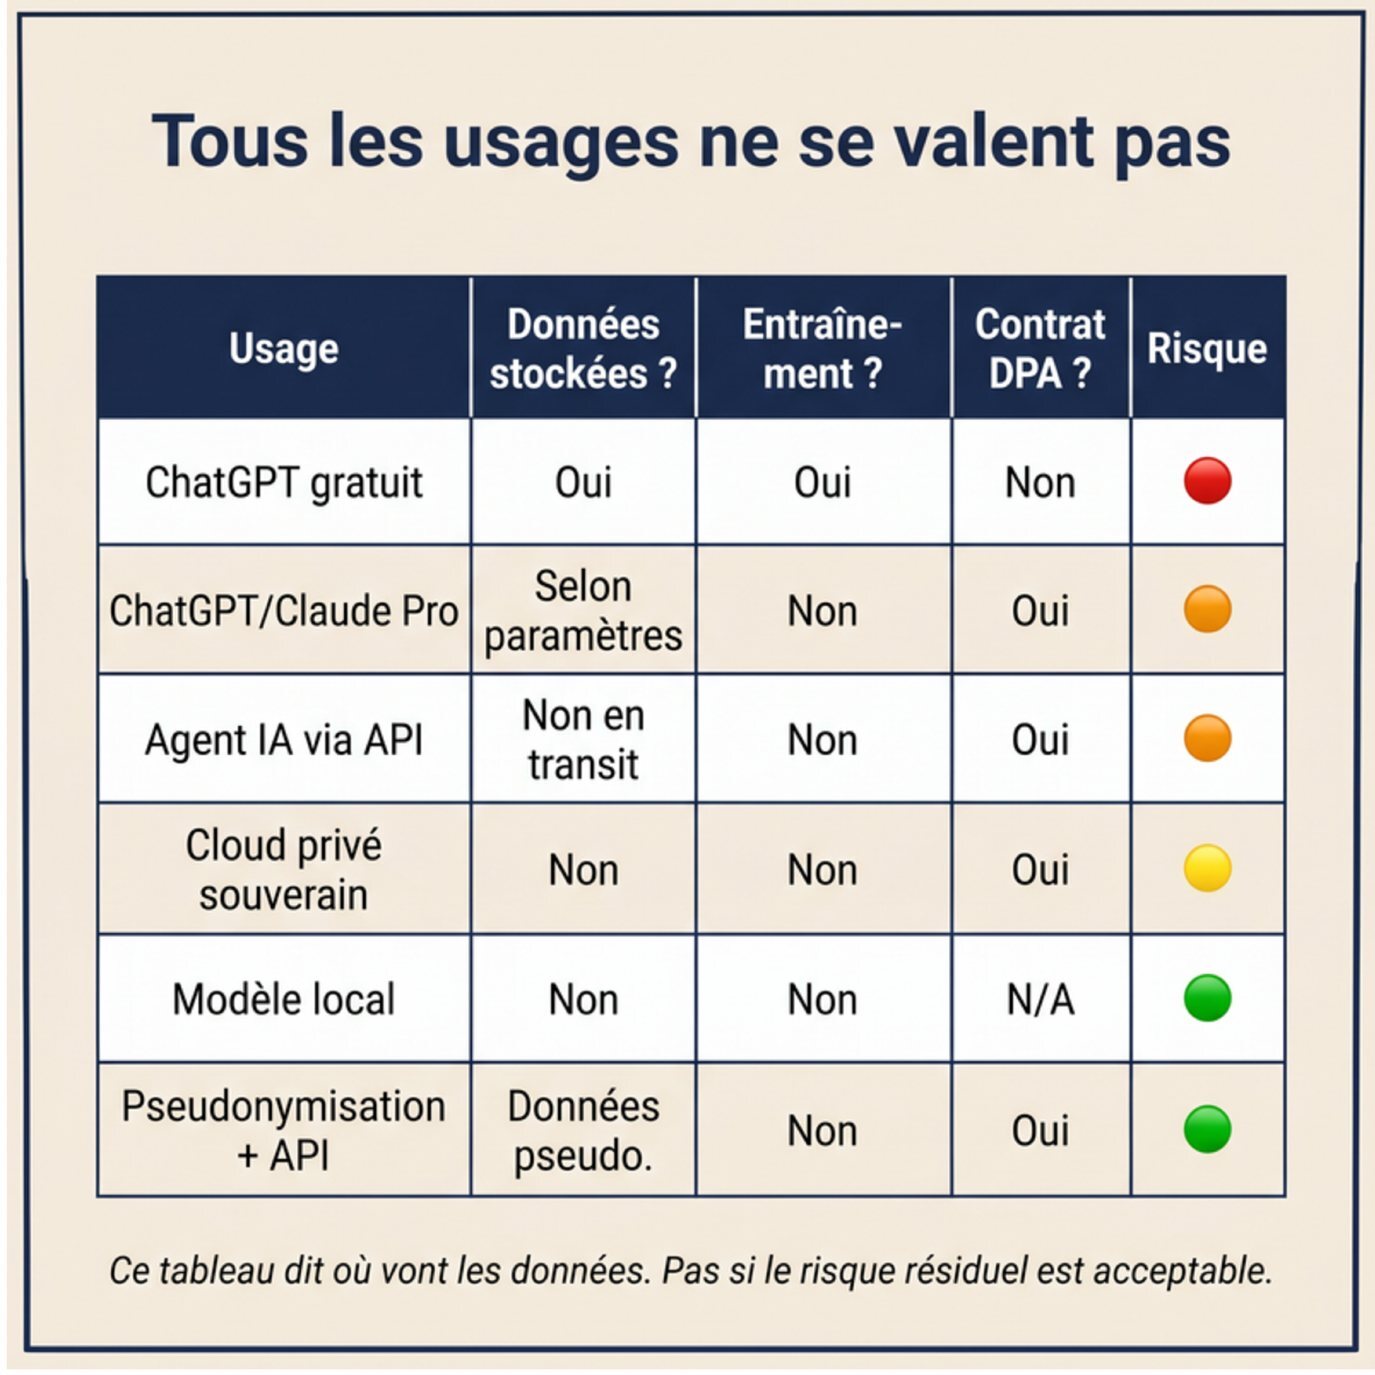
Quatre questions permettent d’évaluer un usage : les données sont-elles stockées quelque part ? Servent-elles à entraîner un modèle ? Qui peut y accéder et les réidentifier ? Le contrat avec le fournisseur protège-t-il réellement ?
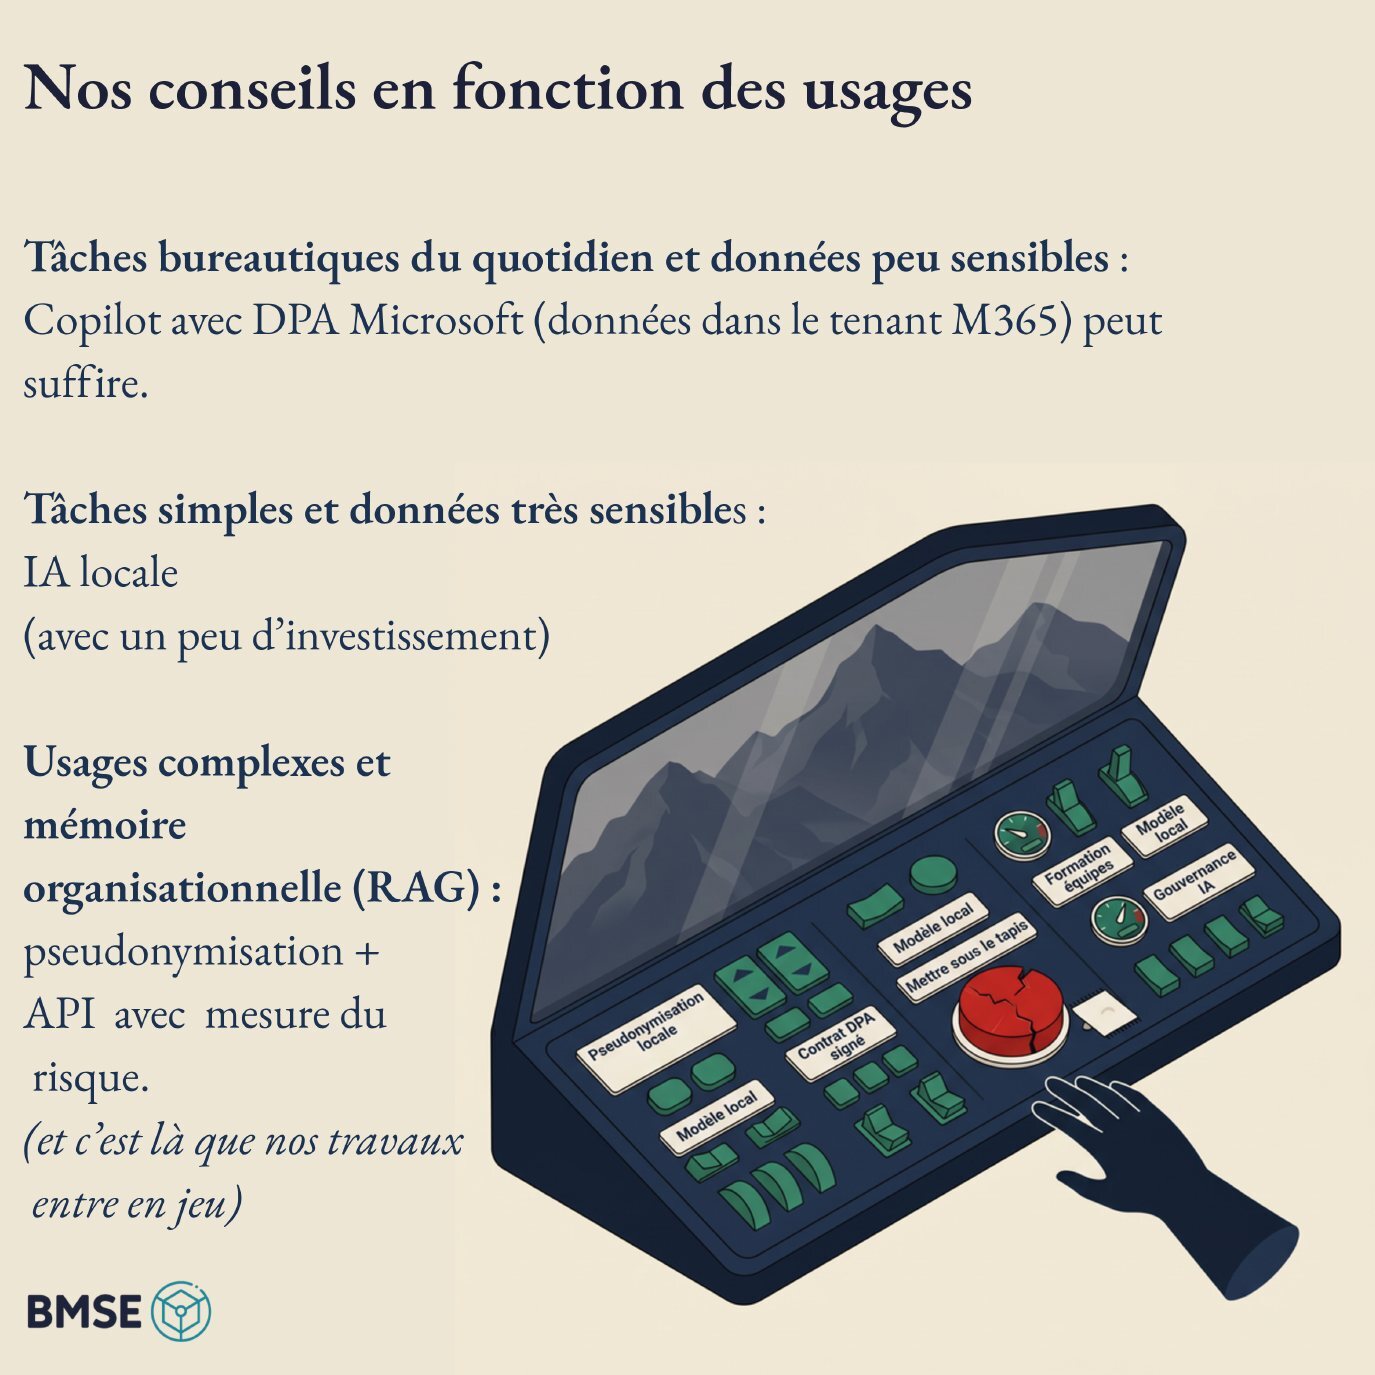
Nos conseils, en fonction des usages :
- tâches bureautiques du quotidien et données peu sensibles : un assistant bureautique couvert par un contrat de sous-traitance (DPA) avec l’éditeur, les données restant dans l’environnement de l’organisation, peut suffire ;
- tâches simples et données très sensibles : l’IA locale, avec un peu d’investissement ;
- usages complexes et mémoire organisationnelle (RAG) : pseudonymisation et API, avec une mesure du risque. C’est là que nos travaux entrent en jeu.
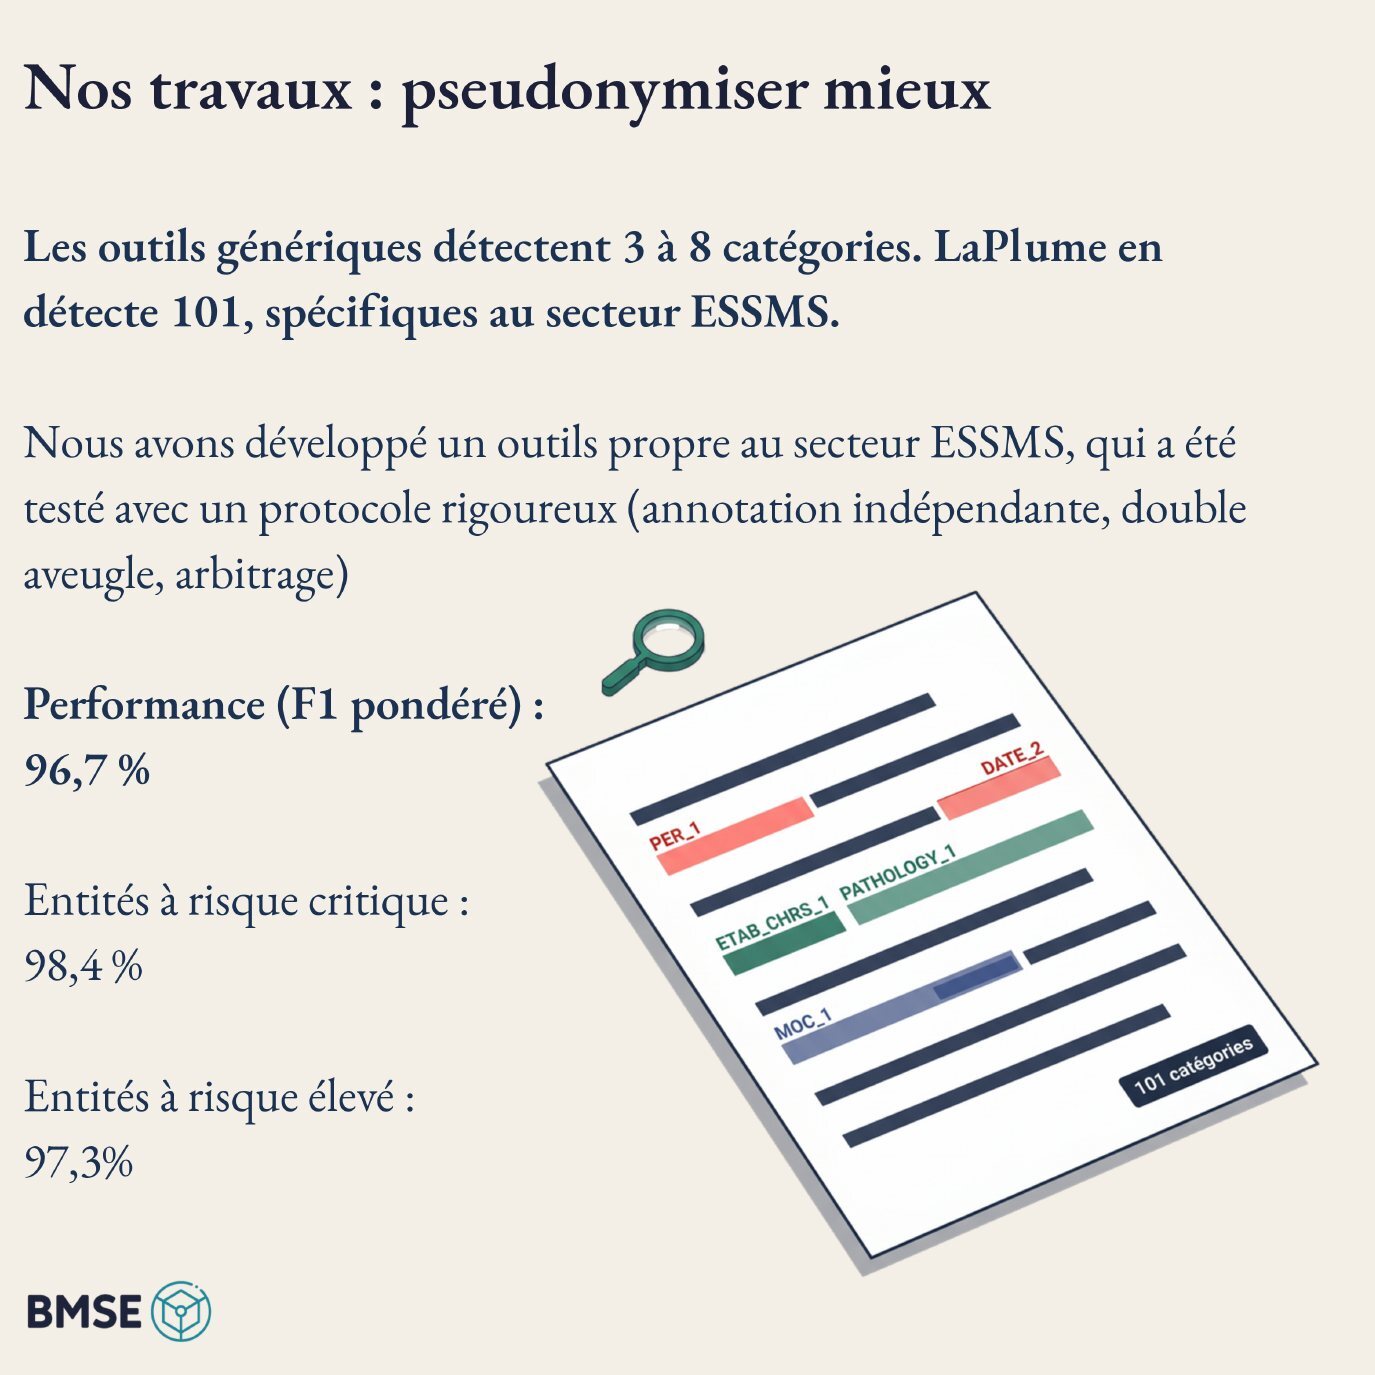
Nos travaux : pseudonymiser mieux, et mesurer le risque
Les outils génériques détectent trois à huit catégories d’informations identifiantes. Nous avons développé un modèle de pseudonymisation propre au secteur, capable d’en détecter 101, testé selon un protocole rigoureux (annotation indépendante, double aveugle, arbitrage) : 96,7 % de performance globale (F1 pondéré), 98,4 % sur les entités à risque critique, 97,3 % sur les entités à risque élevé. Il repère aussi bien des prénoms isolés que des noms d’associations, des numéros de dossier ou des pathologies noyées dans du texte libre.
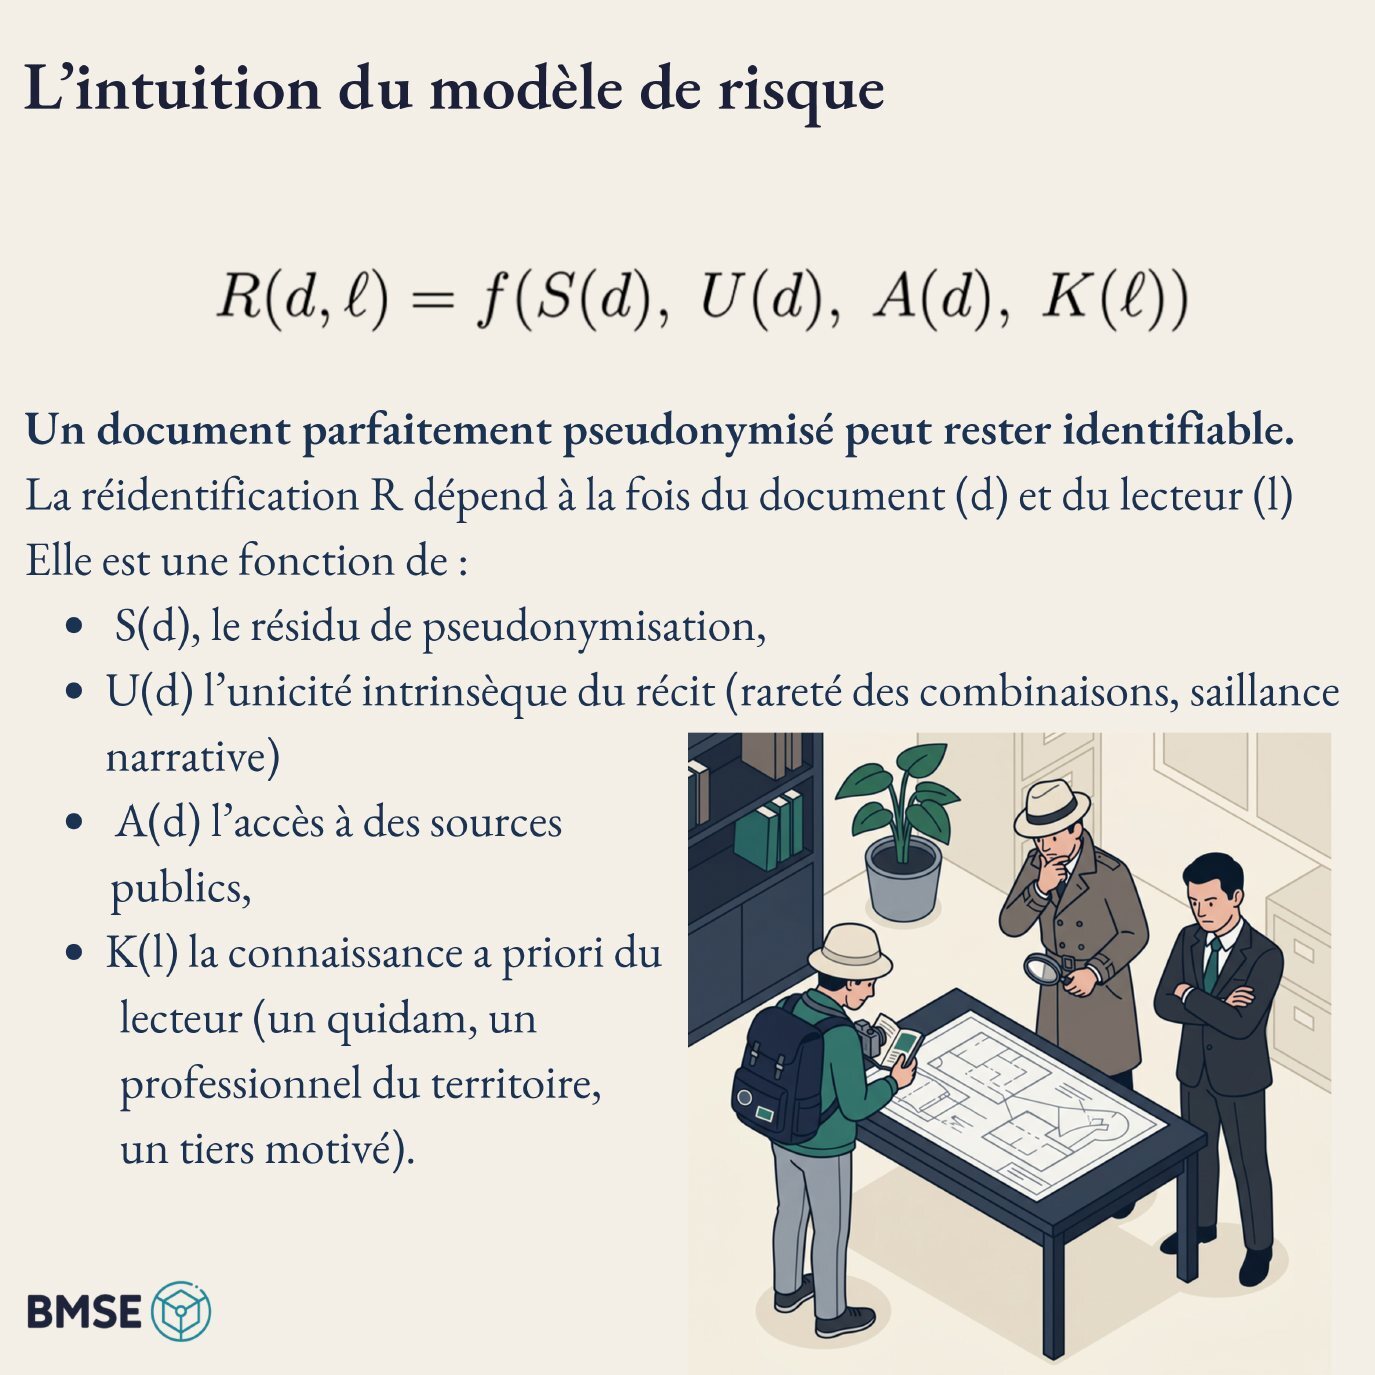
Mais pseudonymiser est la condition nécessaire, pas l’objectif. Nous avons donc construit un modèle de risque de réidentification et l’avons appliqué à 463 documents sociaux et médico-sociaux variés, issus d’un corpus synthétique et préalablement protégés. Quelques résultats nous ont particulièrement surpris :
- un professionnel du secteur a près de cinq fois plus de chances de reconnaître une situation qu’un lecteur extérieur ;
- un récit marquant présente un risque de réidentification environ deux fois supérieur à un récit simplement rare.
La conclusion est assez simple : la protection des données est autant un sujet de gouvernance documentaire qu’un sujet technologique.
La nouvelle frontière : la mémoire organisationnelle
L’objectif est de rendre exploitables les savoirs que les organisations accumulent sans pouvoir les mobiliser : retours d’expérience, arbitrages difficiles, situations marquantes. Les systèmes RAG le permettent. Mais les documents les plus précieux pour la mémoire organisationnelle sont aussi ceux qui posent les problèmes de protection des données les plus aigus. C’est la tension centrale que nos travaux cherchent à résoudre, et c’est sur cette base que nous concevons des systèmes RAG spécialisés pour le secteur.
Ces travaux sont exploratoires, et ce qui reste à faire est au moins aussi intéressant. Nous recherchons des ESSMS partenaires (sous accord DPO), des chercheurs en psychologie cognitive, en droit du RGPD ou en sciences de l’information, ainsi que des DPO prêts à partager leur expérience de terrain.
Faites défiler les planches ; cliquez pour les ouvrir en grand.